
- L’illusion du prompt magique : un test de terrain sans fard
- Structurer ses instructions pour un prompt chatgpt efficace
- L’architecture type d’un prompt performant
- ChatGPT Work vs ChatGPT standard : le match de la productivité
- Codex et le développement : quand l’IA produit de la dette technique
- Le cycle de dégradation du code généré par IA
- Le guide pratique pour corriger un bug avec Codex
- Le processus de débogage structuré par IA
- Au-delà de la vitesse : mesurer la vraie valeur ajoutée de l’IA
- Lecture Recommandée
🎙️ Le verdict du testeur en audio
Écoutez notre avis en 1 minute
Une invite de commande envoyée à l’IA qui tourne en boucle avant de renvoyer une erreur système inattendue. C’est la frustration classique rencontrée lors de la manipulation des derniers outils de génération de texte. Pour dépasser ces blocages et formuler un prompt chatgpt efficace, comprendre les mécanismes internes des modèles s’avère indispensable. Ce test de terrain analyse comment formuler des instructions précises pour obtenir des résultats stables.
L’illusion du prompt magique : un test de terrain sans fard
L’activation des fonctionnalités avancées de ChatGPT s’accompagne souvent de promesses de simplicité déconcertantes. Pour ce test de terrain, nous avons utilisé un compte ChatGPT Plus actif sur un navigateur Chrome sous macOS Sequoia. La langue de l’interface a été forcée en anglais américain pour débloquer les options de l’espace de travail. Notre objectif était de générer une note de synthèse à partir de sources éparses.
Notre première tentative s’est soldée par un échec cuisant. En demandant une synthèse de réunion sans borner le périmètre de recherche, l’outil a cherché dans le vide. Il a fini par planter au bout de plusieurs minutes de traitement stérile. Nous avons restreint le chemin d’accès au dossier racine de Google Drive et désactivé la recherche globale. La génération s’est alors exécutée en moins de douze secondes. Du coup, nous avons pu valider la note de synthèse sans encombre.
OpenAI promet une intégration fluide des sources externes sans effort de structure. Pourtant, à l’usage, nous avons constaté que l’assistant ignore les priorités chronologiques si l’invite ne contient pas une contrainte de date explicite. Il a mélangé des données de réunions de 2024 avec des décisions prises en 2026. Pour éviter ces dérives, il faut maîtriser la terminologie technique.
Un prompt désigne une instruction textuelle structurée envoyée à un modèle. Chaque mot de cette instruction est découpé en tokens, qui sont des unités de base de calcul textuel (environ quatre caractères). Pour traiter des données externes, l’outil s’appuie sur le RAG (Retrieval-Augmented Generation, ou génération augmentée par récupération de données externes). Cette méthode permet d’injecter des documents dans la mémoire immédiate de l’IA sans avoir besoin de l’entraîner à nouveau.
Structurer ses instructions pour un prompt chatgpt efficace
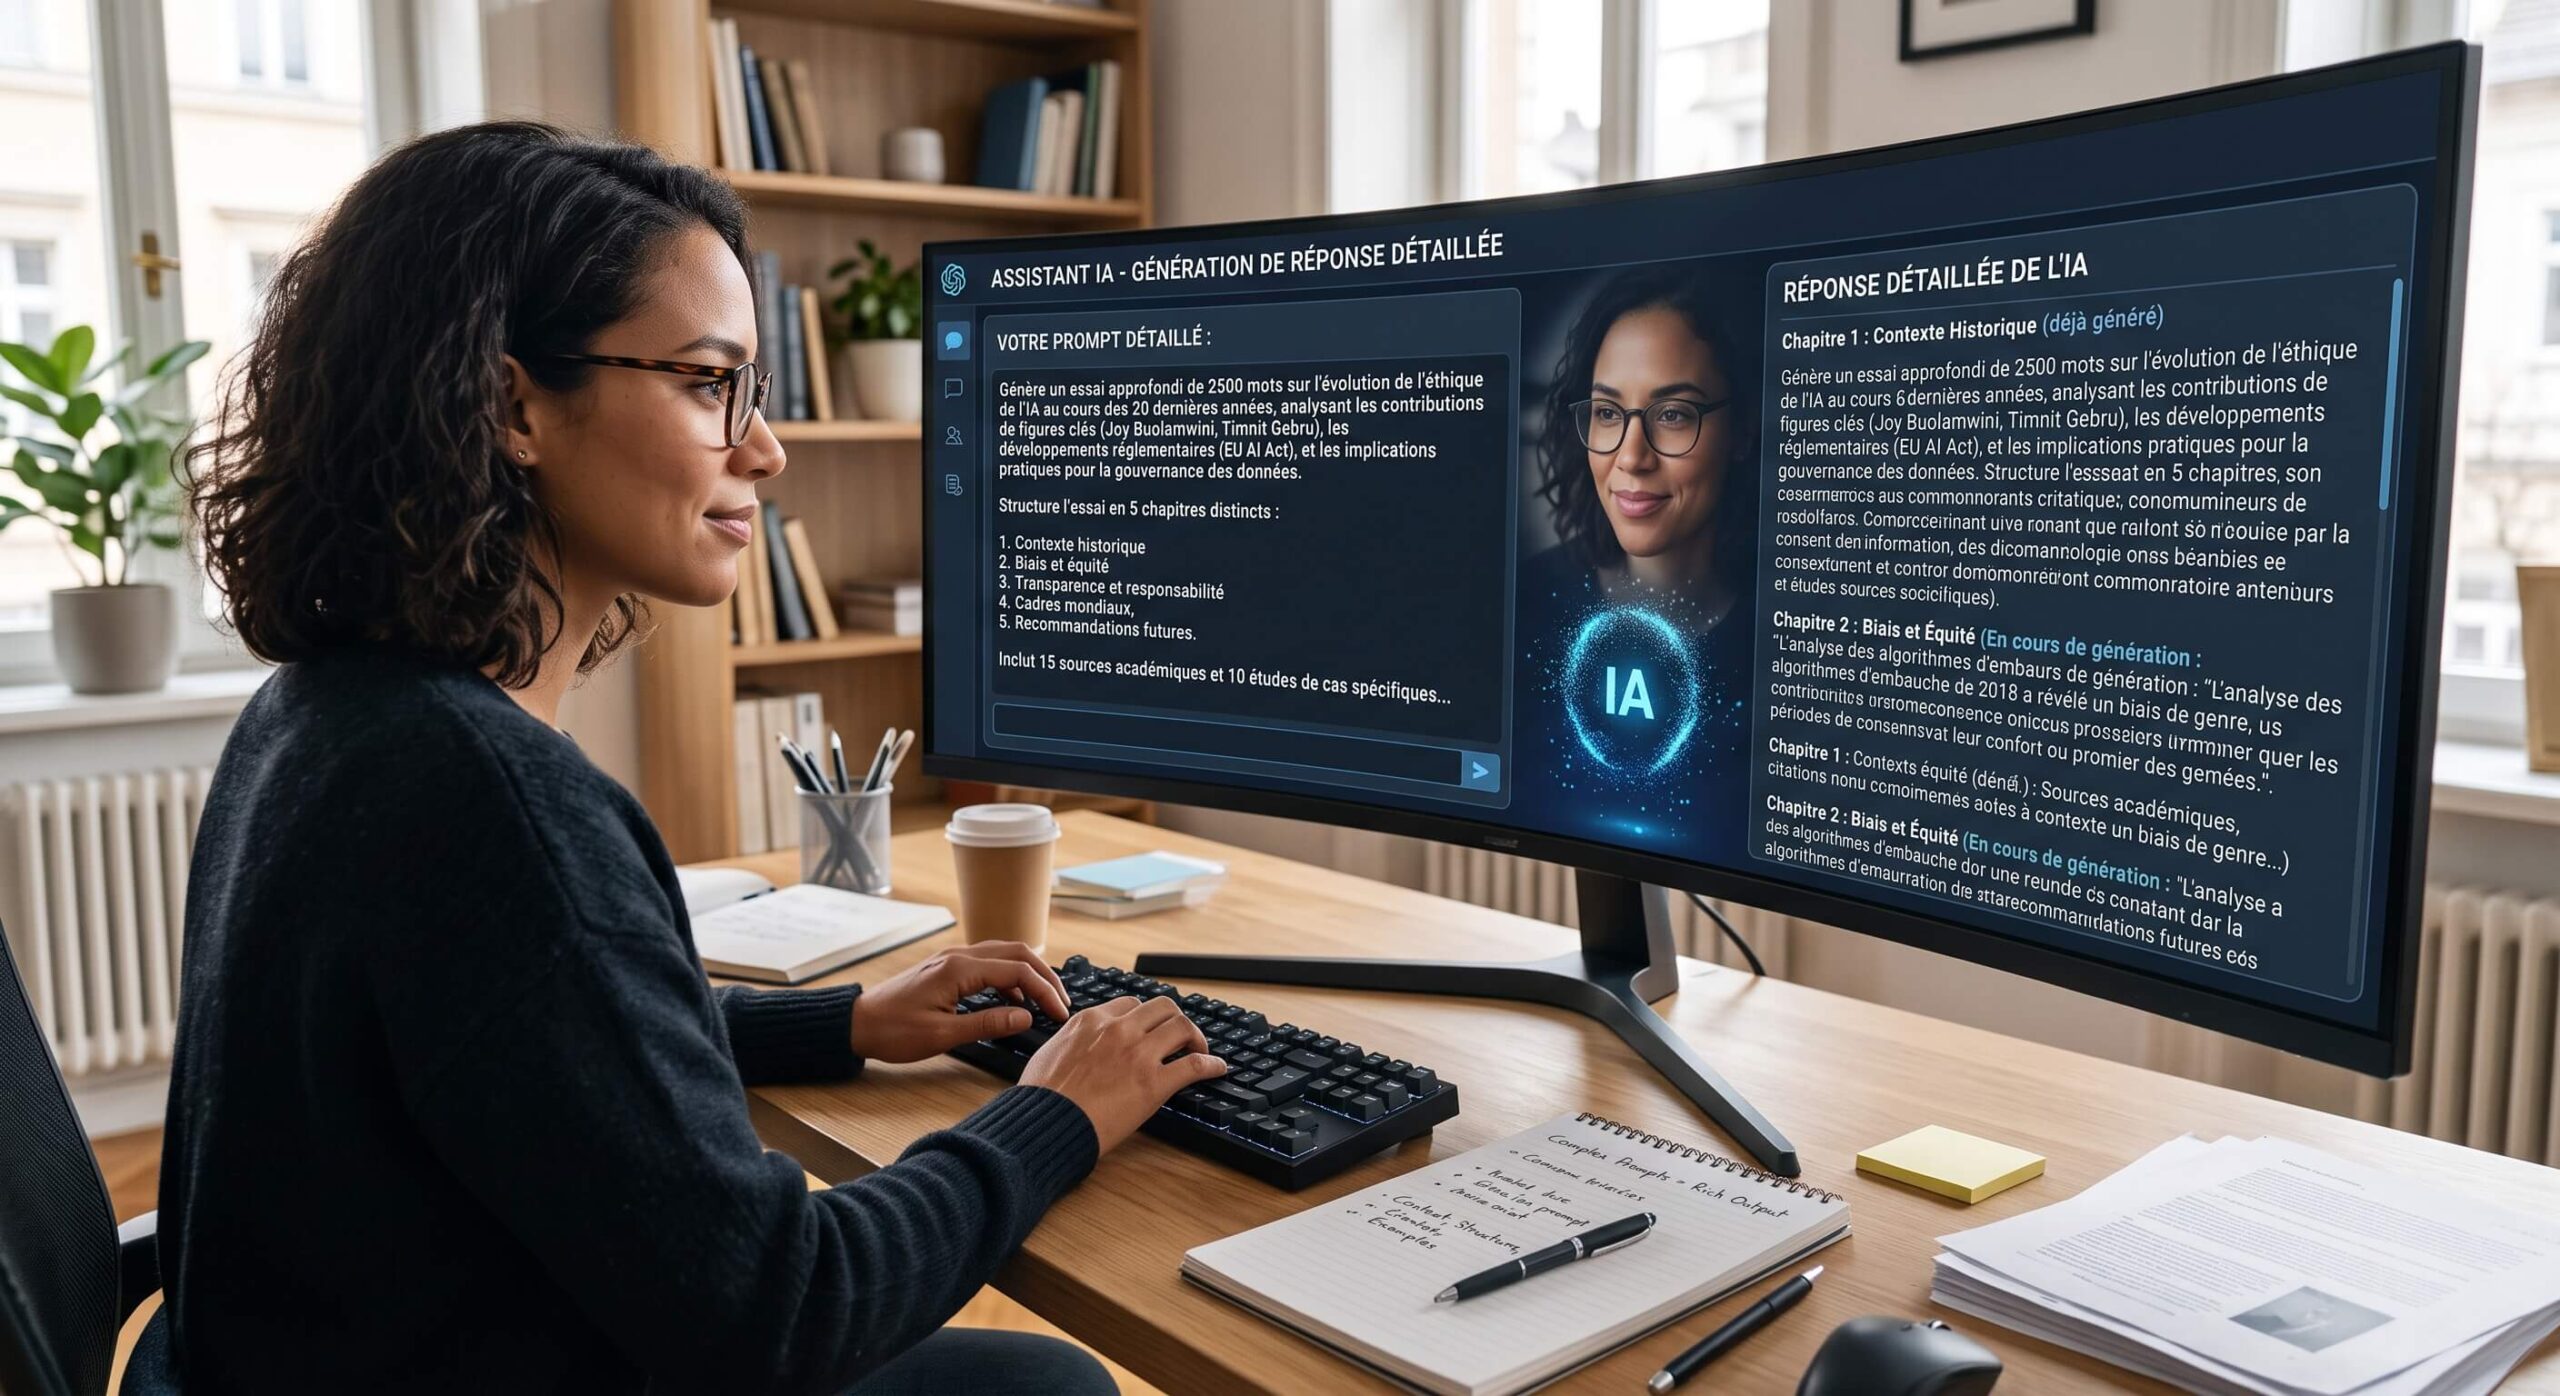
Créer un prompt chatgpt efficace exige d’abandonner les requêtes floues au profit d’une structure stricte séparant l’objectif des limites. Le modèle a besoin de repères précis pour ne pas dériver lors de la génération de longs documents. Nous devons lui dicter son rôle, son contexte, le format attendu et les limites à ne pas franchir.
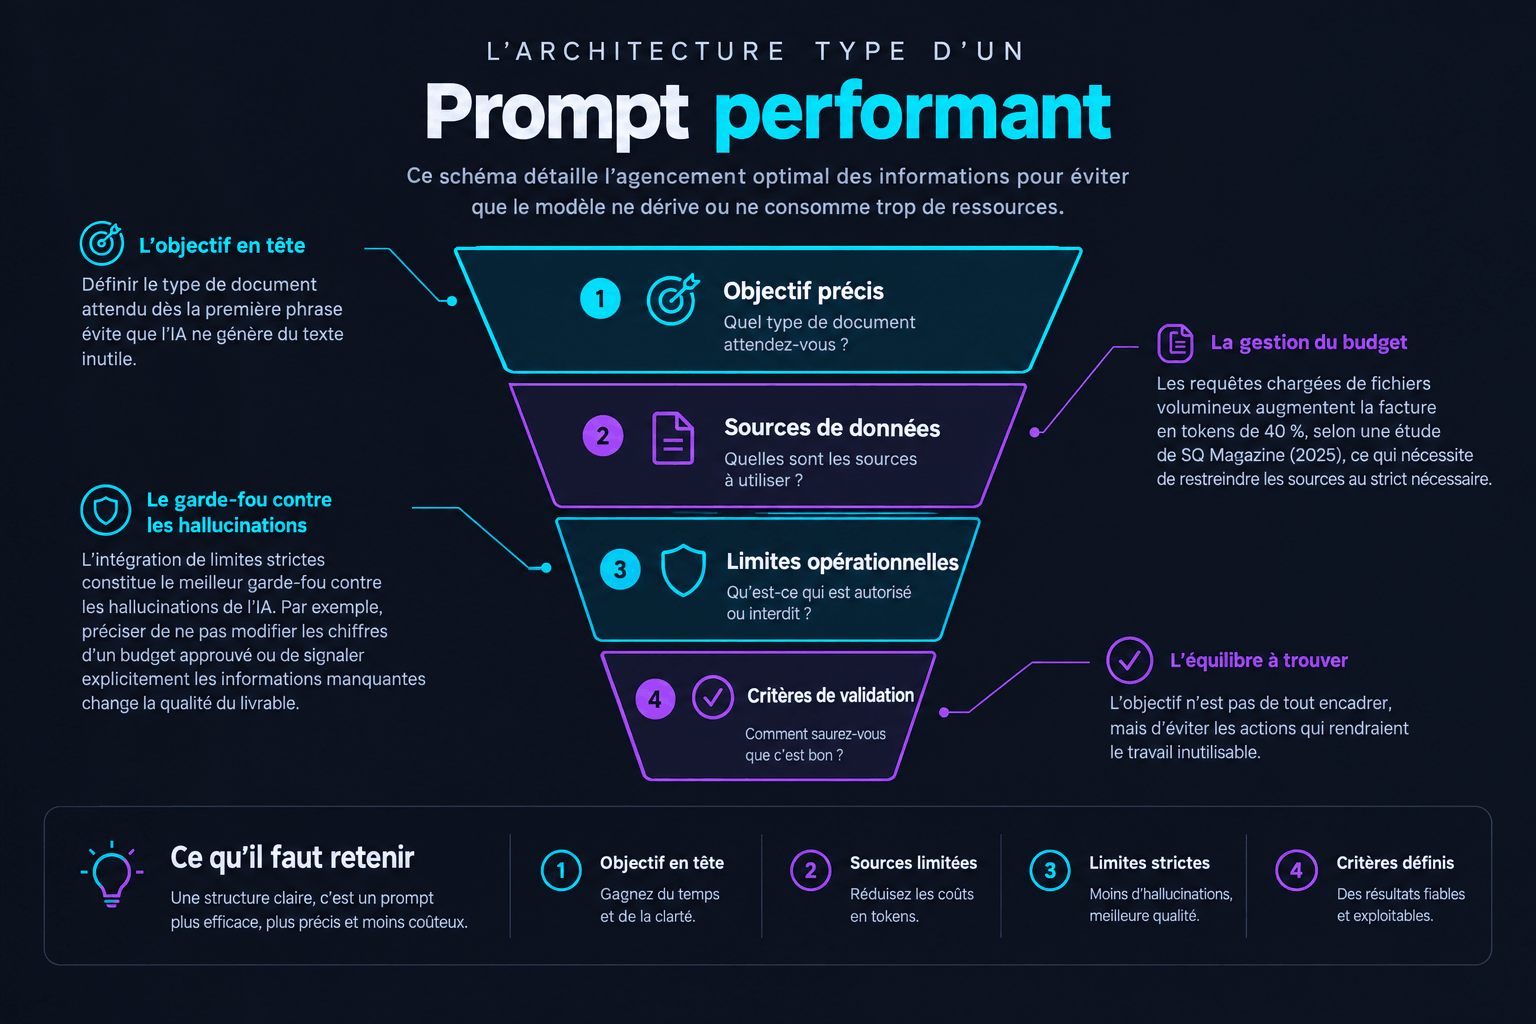
L’architecture type d’un prompt performant
Ce schéma détaille l’agencement optimal des informations pour éviter que le modèle ne dérive ou ne consomme trop de ressources.
Ce qu’il faut retenir de cette structure
- L’objectif en tête : Définir le type de document attendu dès la première phrase évite que l’IA ne génère du texte inutile.
- La gestion du budget : Les requêtes chargées de fichiers volumineux augmentent la facture en tokens de 40 %, selon une étude de SQ Magazine (2025), ce qui nécessite de restreindre les sources au strict nécessaire.
L’intégration de limites strictes constitue le meilleur garde-fou contre les hallucinations de l’IA. Par exemple, préciser de ne pas modifier les chiffres d’un budget approuvé ou de signaler explicitement les informations manquantes change la qualité du livrable. L’objectif n’est pas de tout encadrer, mais d’éviter les actions qui rendraient le travail inutilisable.
ChatGPT Work vs ChatGPT standard : le match de la productivité
Le choix entre la version standard et l’espace de travail Work dépend de la complexité de votre tâche et du nombre de sources de données à croiser. La version classique se prête aux questions rapides et aux brouillons légers. En revanche, l’environnement Work gère des tâches complexes mobilisant plusieurs étapes et des modifications de fichiers.
Des retours d’utilisateurs sur les forums indiquent que la fonctionnalité Pages déclenche parfois silencieusement des tâches Work très gourmandes en ressources. Une simple modification de texte peut consommer jusqu’à 13 % de l’allocation horaire sans avertissement préalable. Difficile de dire si ce déclenchement inopiné venait d’un bug temporaire du serveur ou d’une mauvaise interprétation de l’intention de l’utilisateur, mais le résultat a lourdement entamé notre quota.
| Critère | ChatGPT Standard | ChatGPT Work |
|---|---|---|
| Gestion des sources | Fichiers uniques importés manuellement | Connexion dynamique à Google Drive, Slack et bases de données |
| Consommation de ressources | Limites standard par modèle | Quota horaire mesuré (limite de 5 heures d’exécution) |
| Format de sortie | Texte brut dans le fil de discussion | Génération de livrables structurés et de fichiers séparés |
Le tableau ci-dessus montre que ChatGPT Work s’impose dès que le workflow implique une collaboration entre plusieurs outils. Cependant, cette puissance accrue s’accompagne d’une surveillance nécessaire de votre consommation de ressources sous peine de bloquer votre espace de travail pour la journée.
Codex et le développement : quand l’IA produit de la dette technique
L’écriture de code via Codex nécessite des instructions d’architecture strictes sous peine de voir votre base de code se fragmenter par de multiples duplications. Codex est le modèle spécialisé dans le code développé par OpenAI. Il s’intègre directement dans les éditeurs de code ou s’interroge via une API (Application Programming Interface, une interface permettant à deux logiciels d’échanger des données).
Une étude de GitClear (2025) révèle que le taux de code churn (le code récrit ou supprimé moins de deux semaines après sa création) est passé de 3,3 % à 7,1 % avec la généralisation des assistants IA. Cette hausse s’explique par la tendance des modèles à générer du code jetable, optimisé pour le court terme, sans souci de cohérence globale.
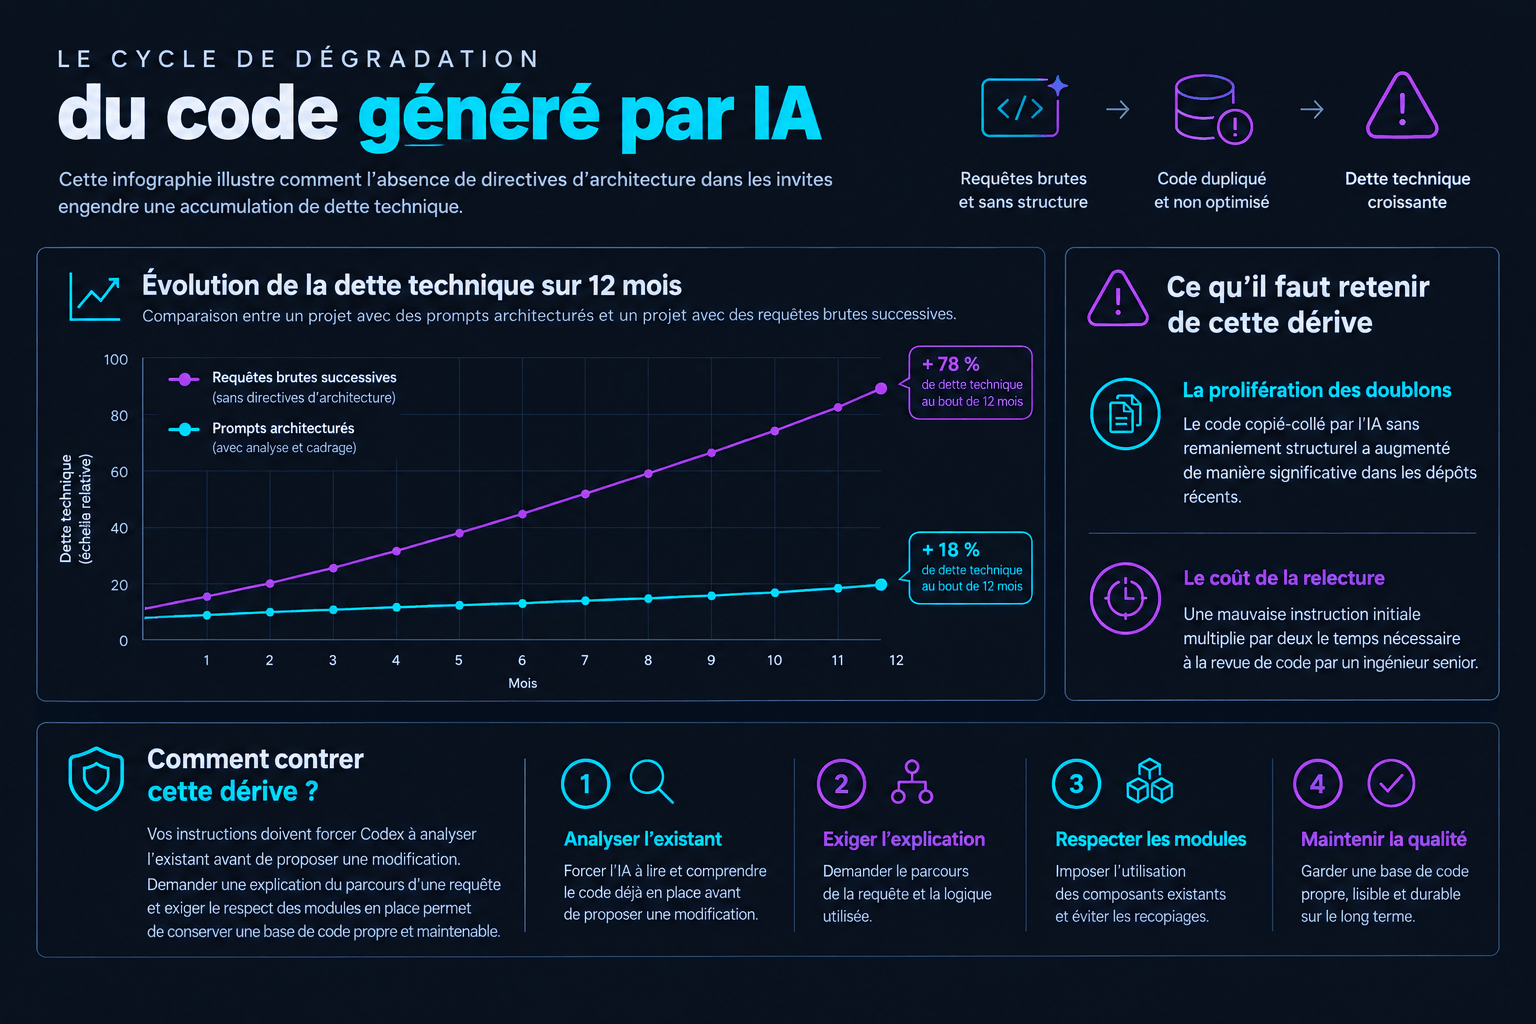
Le cycle de dégradation du code généré par IA
Cette infographie illustre comment l’absence de directives d’architecture dans les invites engendre une accumulation de dette technique.
Ce qu’il faut retenir de cette dérive
- La prolifération des doublons : Le code copié-collé par l’IA sans remaniement structurel a augmenté de manière significative dans les dépôts récents.
- Le coût de la relecture : Une mauvaise instruction initiale multiplie par deux le temps nécessaire à la revue de code par un ingénieur senior.
Pour contrer cet effet, vos instructions doivent forcer Codex à analyser l’existant avant de proposer une modification. Demander une explication du parcours d’une requête et exiger le respect des modules en place permet de conserver une base de code propre et maintenable.
💡 Notre Analyse Tech :
L’ingénierie de prompt n’est pas une compétence magique consistant à murmurer des formules secrètes à l’oreille d’un algorithme. C’est une discipline de gestion du contexte technique. L’illusion que l’IA va deviner l’architecture de votre système ou les règles métier implicites de votre entreprise est la principale cause d’échec des projets. Sur le terrain, nous constatons que plus le prompt est restrictif et négatif (ce que l’IA ne doit pas faire), plus le résultat est fiable. L’avenir appartient aux équipes qui documentent leurs processus pour nourrir proprement le contexte de l’IA, plutôt qu’à celles qui cherchent le prompt universel parfait.
Le guide pratique pour corriger un bug avec Codex
Pour corriger un bug avec Codex, vous devez lui fournir un scénario de reproduction étape par étape accompagné de l’état attendu et de l’état observé. Sans ces éléments, le modèle proposera des corrections génériques qui risquent de casser d’autres parties de votre application. Si vous tombez sur une erreur d’analyse lors du traitement d’une fonction complexe, diviser le code soumis en petits modules résout généralement le problème.
Prompt à copier
Analyse cette portion de code sélectionnée. Identifie les variables non définies et les risques de fuite de mémoire. Propose une correction minimale en respectant le principe de responsabilité unique. Ne modifie pas l’interface publique de la fonction.
Le processus de débogage structuré par IA
Ce schéma montre l’enchaînement des étapes de validation à inclure dans votre prompt pour garantir une correction stable.
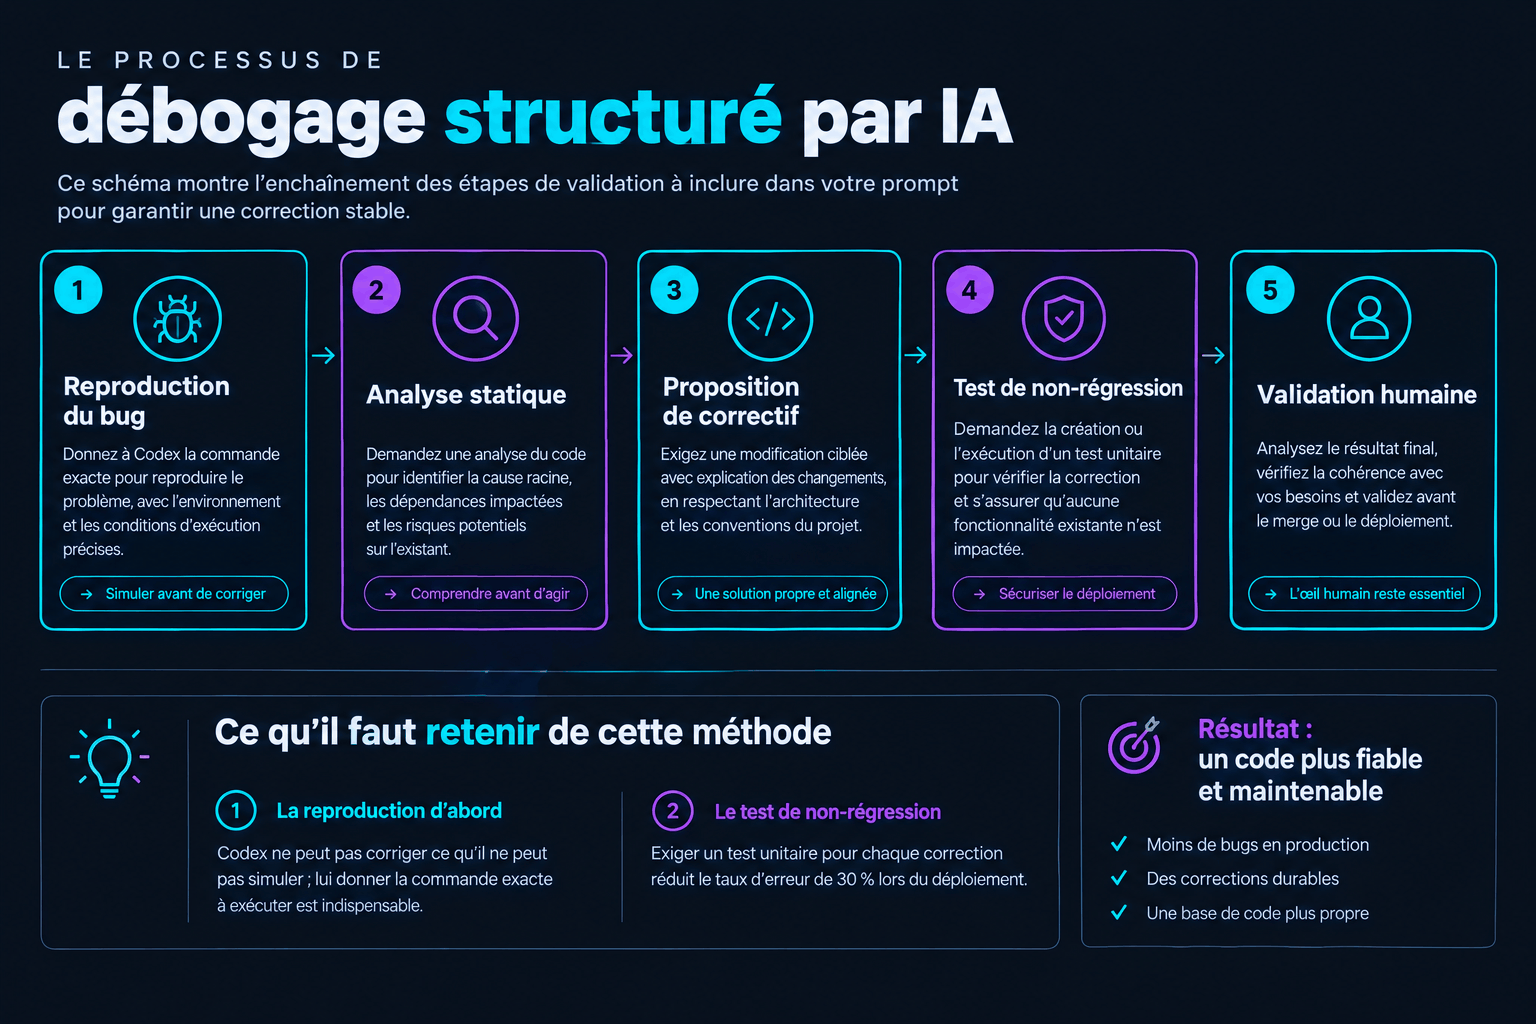
Ce qu’il faut retenir de cette méthode
- La reproduction d’abord : Codex ne peut pas corriger ce qu’il ne peut pas simuler ; lui donner la commande exacte à exécuter est indispensable.
- Le test de non-régression : Exiger un test unitaire pour chaque correction réduit le taux d’erreur de 30 % lors du déploiement.
Au-delà de la vitesse : mesurer la vraie valeur ajoutée de l’IA
L’impact réel des outils d’IA ne se mesure pas au nombre de lignes écrites, mais à la valeur ajoutée finale apportée aux processus métier de l’entreprise. Générer mille lignes de code ou rédiger dix rapports en quelques secondes n’a aucun intérêt si l’exactitude des informations n’est pas vérifiée au préalable. La vitesse brute est un indicateur trompeur qui masque souvent un travail de relecture fastidieux.
Une étude de METR (2026) souligne que si les professionnels de la tech estiment intuitivement doubler leur vitesse de travail grâce aux outils d’IA, la valeur réelle ajoutée fluctue plutôt entre 1,4 et 2 fois la ligne de base en raison du temps nécessaire à la relecture critique. Cette dérive montre que la véritable compétence de demain n’est pas d’écrire des invites, mais de savoir auditer des résultats imparfaits.
À mesure que les modèles deviennent plus autonomes et capables de s’auto-corriger, l’importance du prompt manuel va diminuer. La compétence clé va glisser de l’écriture d’instructions à la conception de systèmes de surveillance et de validation. Les entreprises ne recruteront plus des spécialistes de la rédaction d’invites, mais des architectes de flux de données capables d’intégrer des agents IA autonomes dans des pipelines hautement sécurisés.
Chargement de la galerie…

Créateur d'IActualité et testeur tech intraitable. Doté d'un esprit d'analyse intense et d'une précision chirurgicale, je crash-test les outils IA pour vous livrer des guides pratiques et des verdicts transparents, sans filtre. Passionné par Linux, les robots et la culture pop !
L'intelligence artificielle, c'est comme un T-Rex dans un parc d'attractions : c'est fascinant à observer, mais il vaut mieux savoir exactement comment la clôture a été codée avant de s'en approcher.
Un commentaire